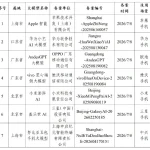
Apple Intelligence Passes China's Latest AI Registration Round
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.
Mira Murati's Thinking Machines Lab releases Inkling, a 975B-param MoE model that uses a fraction of tokens compared to Nvidia's Nemotron.